MapTR 的层级查询设计:用类比理解维度推导
MapTR 把地图元素表示成点集,再用实例查询与点查询组合出结构化查询。我觉得最容易弄错的地方有两个:组合是广播相加,不是拼接;在下面核对的实现里,查询嵌入先是 2D,随后拆成位置和内容两个 D 维部分。MapTR 论文
本文对照的是上游 main 在本次核对时的提交 a6872d8d9670bde17b4b01560f1221f88b443d55,使用 maptr_tiny_r50_24e.py 配置说明形状。它是源码解读,未重跑完整模型或复现论文指标,MapTRv2 和其他配置也不能直接套用这些维度。
用“项目团队”理解层级查询
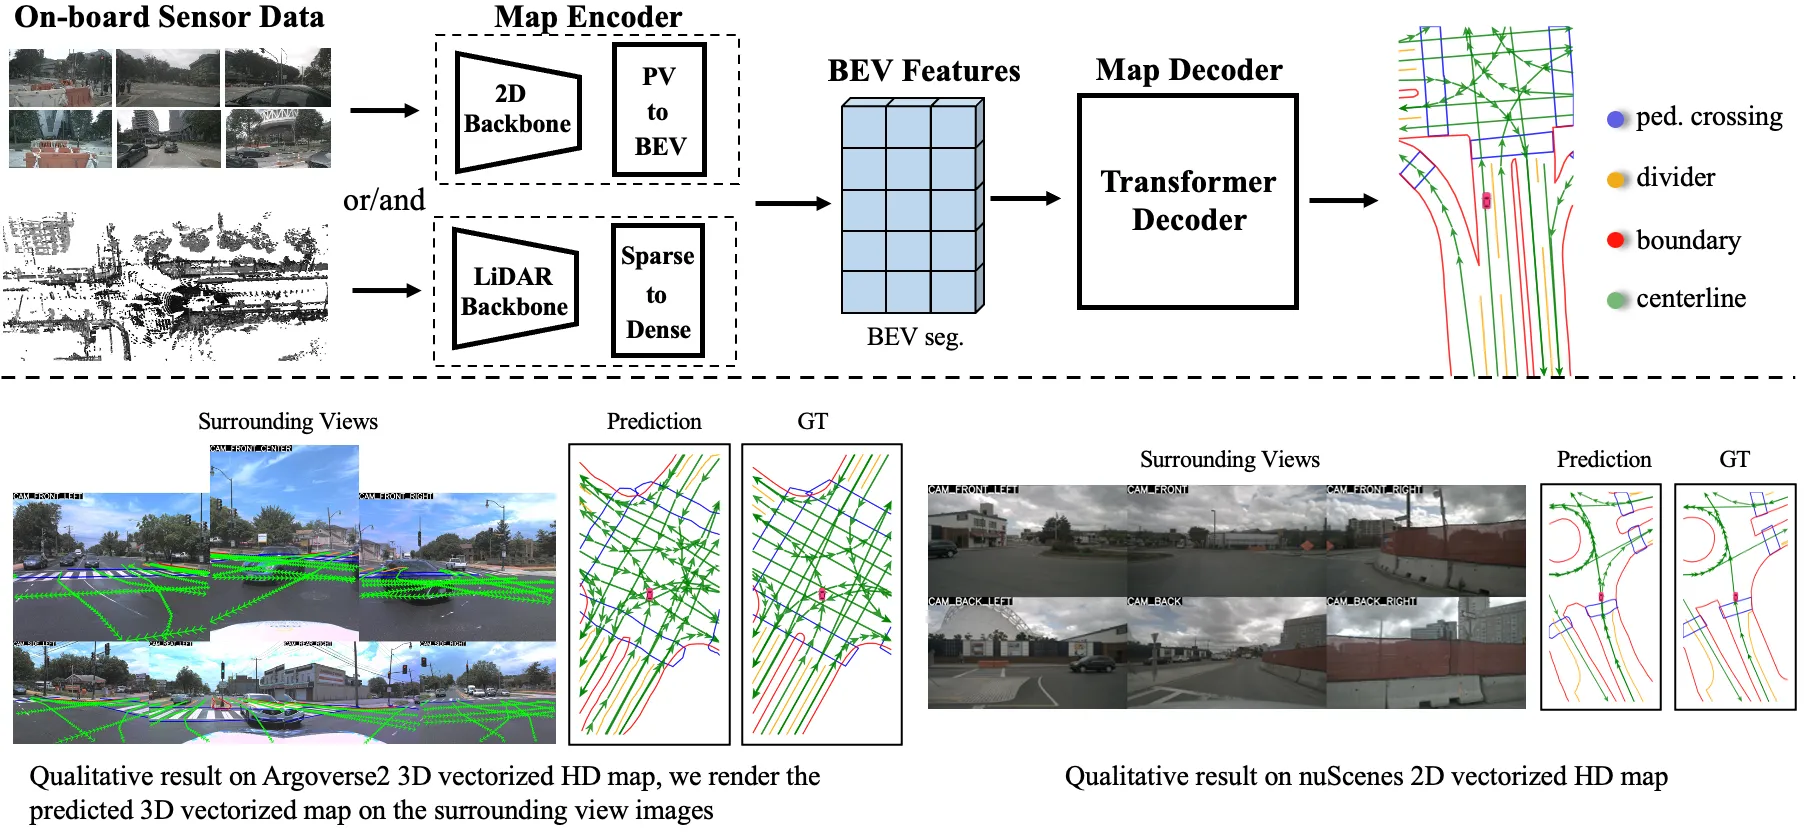
可以把 50 个实例查询看成 50 位建筑师,每位负责一个潜在地图元素;20 个点查询是一组共享的测量员索引。把每位建筑师与每个测量员组合,得到 50 × 20 = 1000 个查询,每个查询对应“某个元素的某个点”。点查询不是预先钉死的起点、转角点角色,具体位置仍由模型学习。
这个类比只解释查询如何组织。MapTR 的另一个关键是把一个地图元素的等价点排列纳入建模和匹配:同一条线换个合理的点序,并不应该变成完全不同的目标。仅把输出写成固定点集,还不足以概括论文的方法。MapTR 论文:结构化建模与层级匹配
源码里的组合其实是 512 维
查询头实现 在 query_embed_type='instance_pts' 时,实例和点嵌入都使用 embed_dims * 2。当 D=256 时:
| 步骤 | 形状 | 含义 |
|---|---|---|
| 实例嵌入 | [50, 512] | 每个潜在地图元素一条嵌入 |
| 点嵌入 | [20, 512] | 每个点索引一条共享嵌入 |
| 实例插入轴 | [50, 1, 512] | 等待对点轴广播 |
| 点插入轴 | [1, 20, 512] | 等待对实例轴广播 |
| 相加 | [50, 20, 512] | 所有实例与点的组合 |
| 展平前两轴 | [1000, 512] | 送给 Transformer 的查询嵌入 |
对每个实例 i、点 j、通道 k,结果都是 instance[i, k] + point[j, k]。共享点嵌入节省的是参数组织,不会把最后 1000 个查询压缩成 70 个计算位置。
先看组合这一步。下面这段可以在 PyTorch 环境中单独运行,后面再把 batch 轴和输出头接起来检查:
import torch
num_instances, num_points, dim = 50, 20, 256instance = torch.zeros(num_instances, 2 * dim)point = torch.zeros(num_points, 2 * dim)combined = instance[:, None, :] + point[None, :, :]query_embed = combined.flatten(0, 1)query_pos, query = query_embed.split(dim, dim=1)assert combined.shape == (50, 20, 512)assert query_pos.shape == query.shape == (1000, 256)
Transformer 实现 再把它沿通道轴拆成 query_pos 和 query,扩展 batch 轴。解码器接收的内容查询与位置查询都是 [1000, B, 256];由位置查询生成的初始参考点是 [B, 1000, 2],经 sigmoid 归一化。
注意力类比,不能当成实际计算图
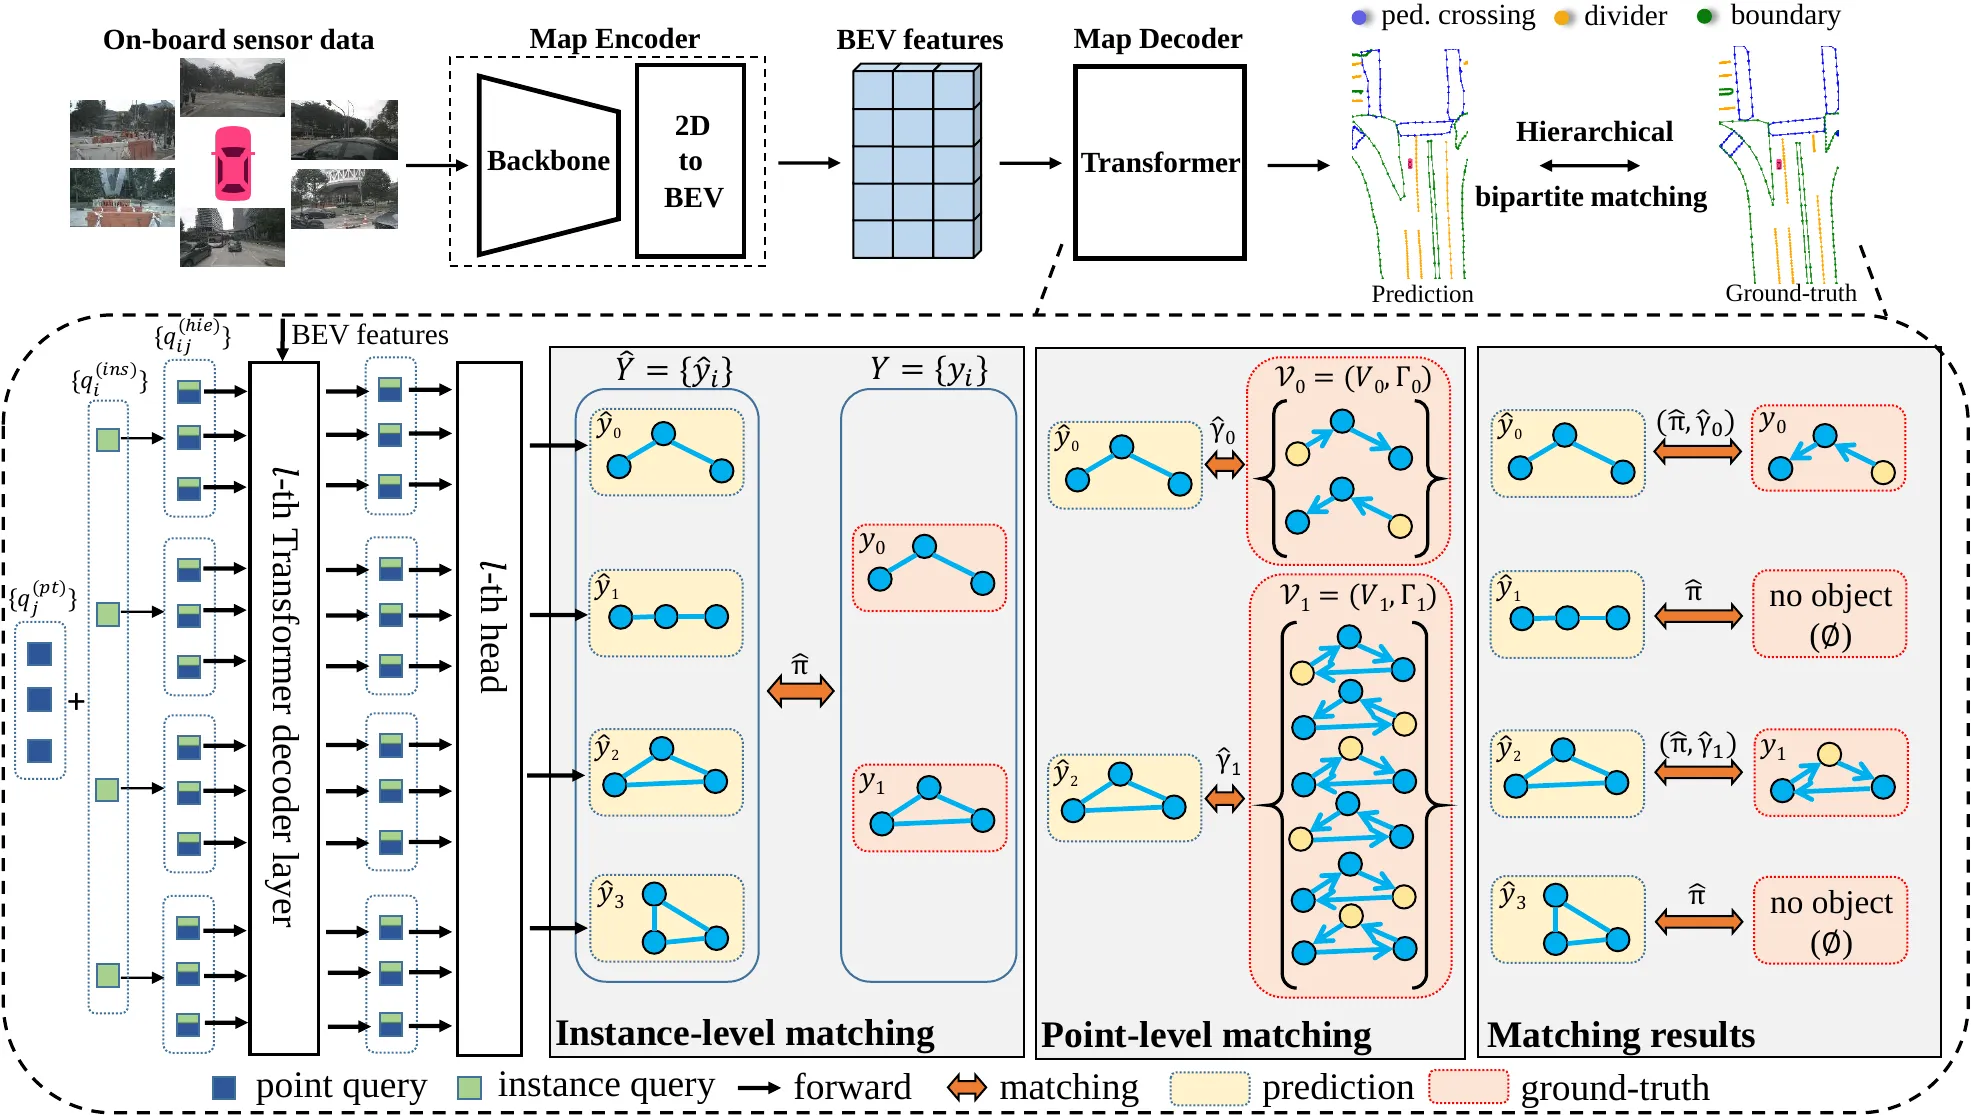
“查询去地图上找相关信息”这个直觉没问题,但把它直接写成对整张 BEV 做 QKᵀ,就把解释模型和实际实现混在一起了。所用配置 的解码器使用 MultiheadAttention 做查询之间的自注意力,使用 CustomMSDeformableAttention 从 BEV 特征取信息。
密集交叉注意力可以用 Q: [1000, D]、K: [N, D]、权重 [1000, N] 来讲入门概念,但它不是这份配置的真实交叉注意力。可变形注意力围绕参考点,以学习的偏移和权重采样少量位置,不必显式构建这张完整的密集权重矩阵。与此同时,查询间的自注意力仍有自己的计算开销,不能因此说整个网络复杂度都变成了线性。
也要区分两层查询:BEV 编码器用自己的 BEV 查询组织鸟瞰特征,地图解码器才用这里的实例—点查询预测地图元素。
输出头如何拿回地图元素
每层解码后的查询整理成 [B, 1000, 256]。分类分支先 reshape 成 [B, 50, 20, 256],在 20 个点上取平均,再输出 [B, 50, C] 的类别分数;这个配置的地图类别是 divider、ped_crossing、boundary,C=3。
回归分支逐点预测坐标偏移,与参考点在 inverse-sigmoid 空间结合后再做 sigmoid,最终得到 [B, 50, 20, 2] 的归一化点坐标。把坐标恢复到车辆空间还要结合 pc_range,不能把输出的 [0, 1] 值直接理解成米。源码还从点集计算包围框,并返回各解码层的结果。分类与坐标处理
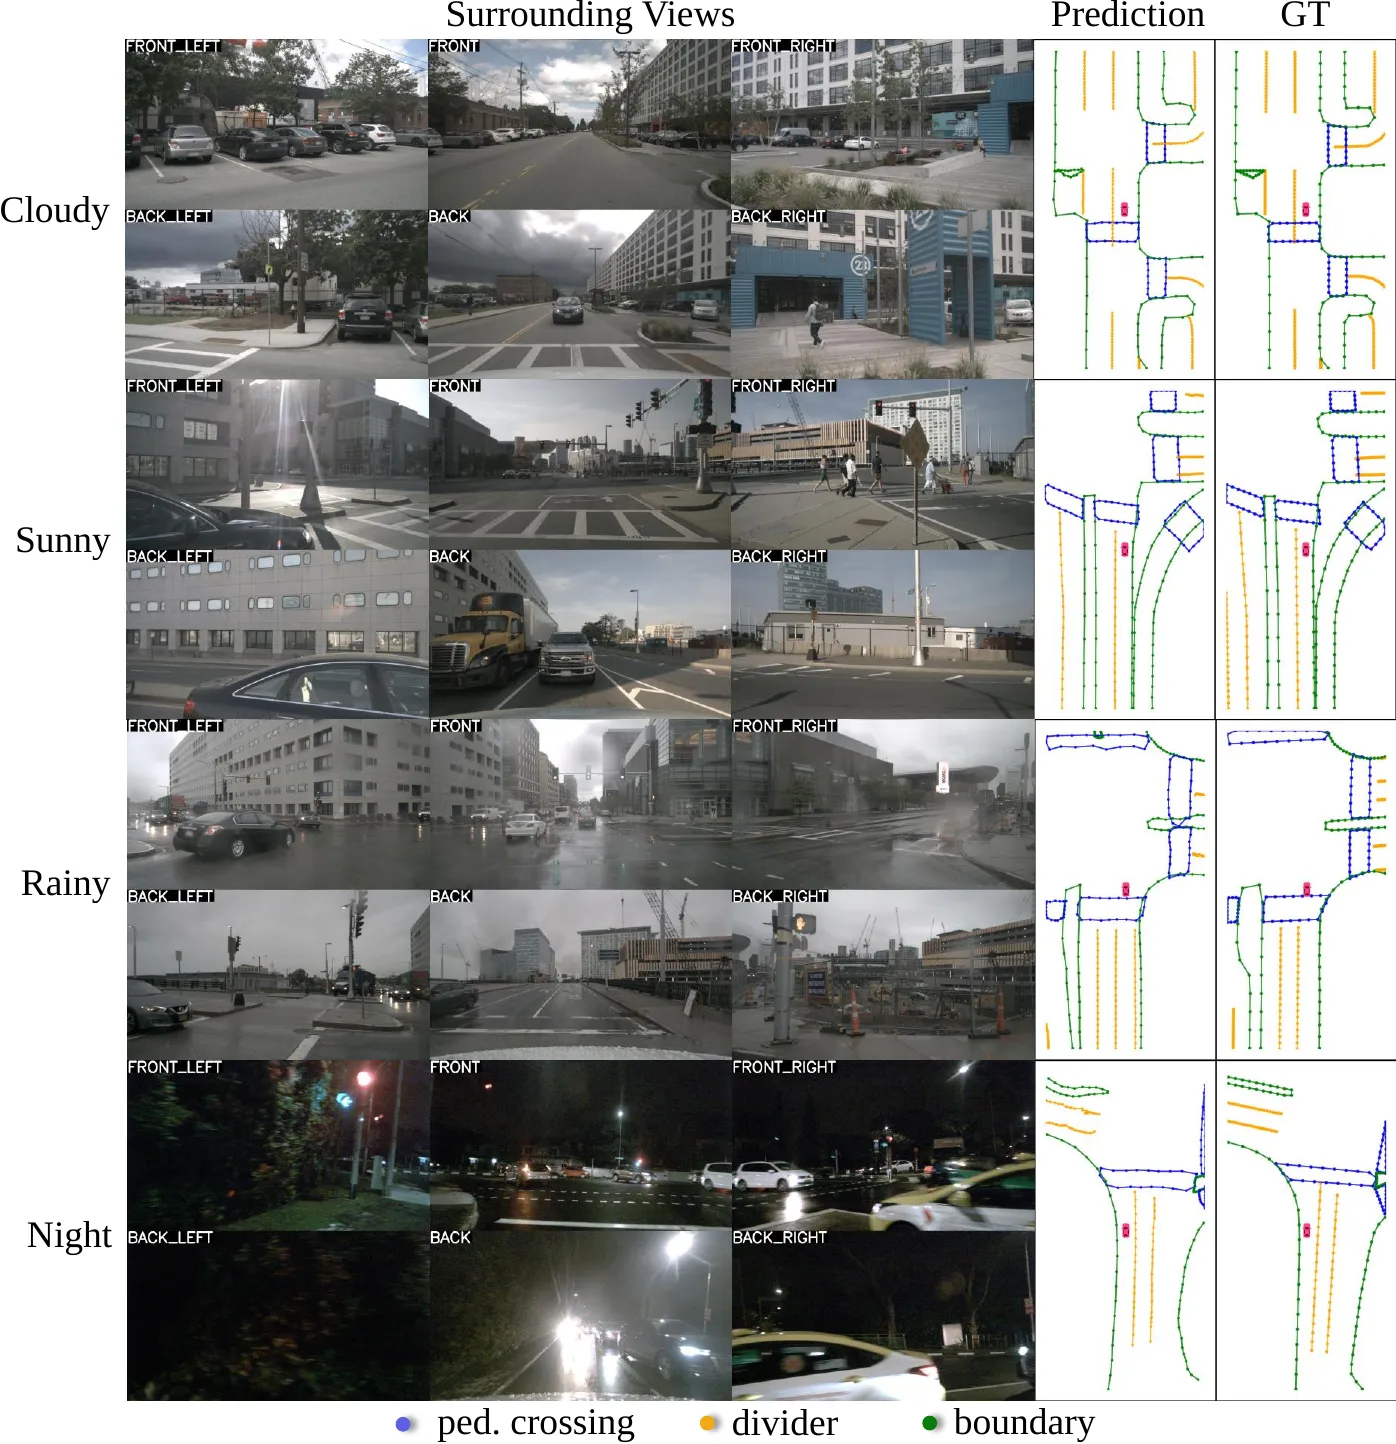
实例数、点数、骨干网络和 BEV 编码器都属于配置选择。图中的预测展示有助于理解输出形式,但不能替代对不同配置的速度、精度和复杂路形的定量评估。
怎么实际跑一遍 query 到输出的维度?
先用 I=2 个实例、P=3 个点、D=4 跑一个看得见的例子,再换成上面配置里的 I=50、P=20、D=256、L=6 检查形状。B=2 是为了让 batch 轴和 query 轴不容易混淆,不是在声称原配置的训练 batch 就是 2。
完整脚本在 maptr-query-shapes.py。只需要 Python 和 PyTorch,CPU 即可,不需要下载 MapTR、数据集、模型权重或编译 MMCV。已有 PyTorch 环境可以跳过安装:
python3 -m venv .venv-maptr-shapessource .venv-maptr-shapes/bin/activatepython -m pip install torchcurl -fL https://tonwork.fun/blog/maptr-query-shapes.py -o maptr-query-shapes.pypython maptr-query-shapes.py先说明边界:这个脚本验证的是查询组合、拆分、轴变换,以及简化输出头的输入输出形状。解码器输出用占位张量代替,分类和回归头用单层 Linear 代替;没有运行自注意力、BEV 可变形采样、逐层参考点更新、匹配或训练。它不是完整 MapTR 推理,更不能用来测速度和精度。
脚本里最值得检查的不是 shape 本身,而是展平之后有没有把“建筑师—测量员”的对应关系弄乱:
# 每个实例用 10 * i 标记,每个共享点用 j 标记。instance = torch.arange(instances, dtype=torch.float32)[:, None].repeat(1, 2 * dim) * 10point = torch.arange(points, dtype=torch.float32)[:, None].repeat(1, 2 * dim)combined = instance[:, None, :] + point[None, :, :]query_embed = combined.flatten(0, 1)
for i in range(instances):    for j in range(points):        torch.testing.assert_close(query_embed[i * points + j], instance[i] + point[j])
小例子的展平顺序是 (0, 0), (0, 1), (0, 2), (1, 0), (1, 1), (1, 2),第一通道应为 [0, 1, 2, 10, 11, 12]。也就是说,第 q 个查询对应实例 q // P、点 q % P。这些值只是帮助定位轴顺序的人工标记,不是训练得到的嵌入。
两组参数应打印以下形状,末尾均为 all assertions passed:
| 脚本检查点 | 小例子 | tiny 配置维度 |
|---|---|---|
广播相加 combined | [2, 3, 8] | [50, 20, 512] |
展平 query_embed | [6, 8] | [1000, 512] |
拆分并扩展 batch,query_pos / query | [2, 6, 4] | [2, 1000, 256] |
初始参考点 reference | [2, 6, 2] | [2, 1000, 2] |
| 解码器入口,sequence-first | [6, 2, 4] | [1000, 2, 256] |
占位解码器输出 hs,[L, Q, B, D] | [2, 6, 2, 4] | [6, 1000, 2, 256] |
简化分类头,[L, B, I, C] | [2, 2, 2, 3] | [6, 2, 50, 3] |
简化点回归头,[L, B, I, P, 2] | [2, 2, 2, 3, 2] | [6, 2, 50, 20, 2] |
注意这里的 hs 要先从 [L, Q, B, D] 换成 [L, B, Q, D],才按实例和点分组。分类是在点轴上平均,每个实例输出一组类别分数;回归仍保留每个点的位置。脚本还检查坐标有限且处于 [0, 1],这只验证数值范围,不说明预测正确,也不意味着坐标已经换成米。
这些步骤分别对应哪段源码?
以下链接都固定在本文核对的提交,避免上游更新后行号和实现悄悄变化:
| 检查内容 | 上游位置 |
|---|---|
2D 嵌入与实例—点广播相加 | maptr_head.py:嵌入初始化、组合与展平 |
| 位置/内容拆分、参考点与 batch 轴变换 | transformer.py |
| 解码层输出的堆叠顺序 | decoder.py |
| 分类聚合、坐标处理与各层输出 | maptr_head.py |
实际解码器还会迭代更新参考点,后续输出层不总是用初始参考点。为了单独看清形状,脚本每个占位层都复用同一份初始参考点,并将生成参考点的线性层置零,让它们从 0.5 开始。这两处都是演示简化,不能搬进实际模型当成等价实现。
为什么配置写了 num_query=900,这里却是 1000?
这份配置确实写了 num_query=900,但对应版本的 MapTRHead 在初始化时用 num_vec * num_pts_per_vec 设置查询数。所以在 instance_pts 路径下,实际展开的是 50 × 20 = 1000。看配置时不能只抓住一个字段,还要看它有没有被构造逻辑重新设置。配置字段、查询数初始化
形状都对了,就说明实现没问题吗?
还不够。比如把点轴和实例轴交换后再展平,查询总数仍然是 I × P,单看形状不一定能发现错误。这个例子额外检查了 q=i*P+j 的数值对应关系。至于点序等价性、匹配、真实注意力和坐标还原,仍要回到模型与数据里验证,不能用这几个断言代替。
如果接下来关心部署,读 BEV 感知的实时性与性能口径;想把训练、地图预测、融合放在同一条阅读路径上,见 BEV 感知工程导读。