评测里的差距有多少是真的?三篇 TMLR 投稿的共同教训
最近投了三篇论文到 TMLR,题目看上去八竿子打不着:一篇讲扩散语言模型判断语法,一篇讲机器人 VLA 在 LIBERO 上的评测,一篇重新分析别人发表的 LLM 群体智能数据。写完回头一看,三篇其实在回答同一个问题:论文里报出来的那个差距,有多少是真的? 我的结论是,比大家默认的要少,而且噪声和分析误差往往能提前算出来。
三篇都是预注册的:先把假设、阈值和分析脚本写死并提交,再跑数据。其中两篇最初的方向其实”失败”了,失败的原因恰好成了论文的主题,这个过程我也一并写出来。
采样数 K 能决定扩散语言模型”懂不懂语法”
扩散语言模型(dLLM)不像自回归模型那样能直接给出一句话的概率,通常要对一个证据下界(ELBO)做蒙特卡洛采样来估计,采样数 K 各家随便定:LLaDA 在似然类基准上用 128 次,单 token 答案只用 1 次,也有工作拿 32 次当对照。这个数平时没人在意,但放到最小对(minimal pair)评测上就出事了。
最小对就是一对只差一点的句子,一句合语法一句不合,看模型是不是给合语法的那句更高概率,BLiMP 和 ZhoBLiMP 就是这么测的。我原本想做一个干净的对照实验:Dream-7B 是从 Qwen2.5-7B 改训成扩散模型的,DiffuLLaMA 是从 Llama-2-7B 改的,初始权重完全一样,正好看”改成扩散目标”会不会损失语法知识。结果预注册的第一阶段在效度检查上就挂了:K=32 时,把采样分成两半,两半对”哪句更可能”的判断只在 77% 的英文句对上一致。估计本身太吵,单个句对根本判不准。
于是第二阶段转而研究噪声本身。对每个句对,单次采样的得分差有均值 μ 和标准差 s,用 K 次采样时判对的概率是 Φ(μ√K/s):μ 为正的句对被噪声往 50% 拉低,整体准确率因此被系统性低估。这条”衰减律”可以用一半样本估参数、去预测另一半样本上的准确率。预注册测试里,Dream-7B(中英文)和 DiffuLLaMA(英文)各用 256 次采样,K 从 4 到 32 的预测平均误差只有 0.6 到 0.8 个百分点。
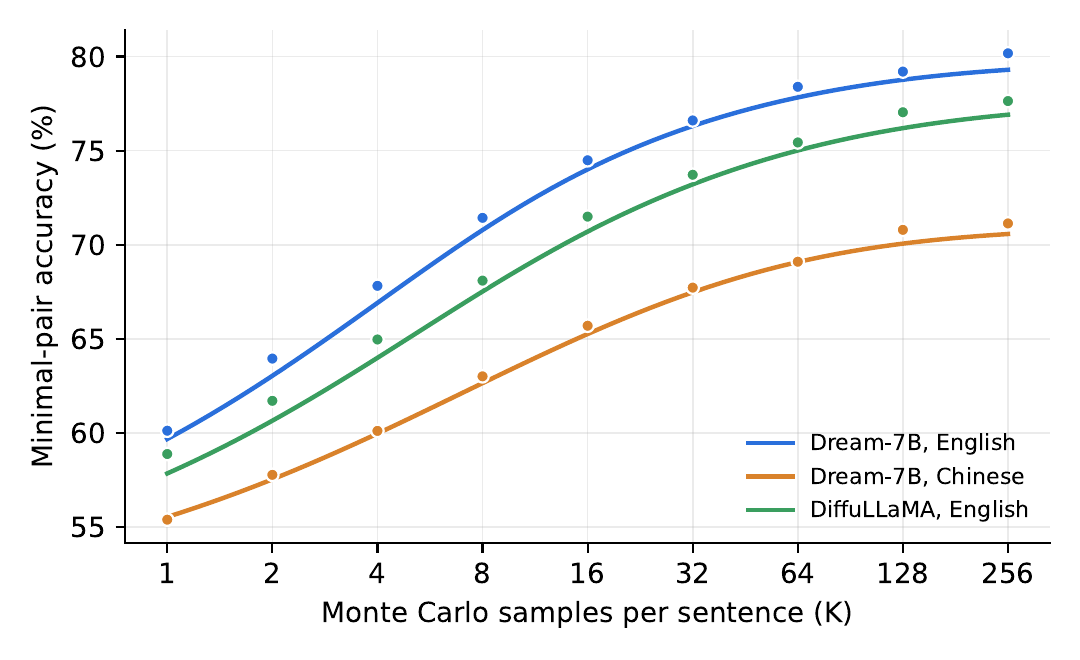
真正有意思的是回到最初的问题。K=32 时,Dream-7B 在英文 BLiMP 上看起来比 Qwen2.5-7B 低 5.4 分;K 提到 256,差距缩到 1.8 分,和确定性的伪对数似然(PLL)给出的结果差不多。也就是说,大约三分之二的”语法损失”是采样噪声。但不是所有损失都是噪声:DiffuLLaMA 在英文上还差约 5 分,Dream 在中文上的损失也基本没缩。所以”改成扩散模型会不会掉语法”的答案取决于具体怎么改,而 K 太小会把代价放大。
我的建议很简单:报告 K;用小规模试跑估出 μ 和 s,按衰减律选 K;采样似然旁边总是附一个确定性估计(比如 PLL)。
LIBERO 上均值很稳,单个 episode 却在乱跳
第二篇换到机器人。LIBERO 是现在 VLA 策略最常用的仿真基准,新方法和最强基线经常只差一两个点:一个公开排行榜里,新方法在 LIBERO-Goal 上领先的表格中,一半的领先幅度不超过 2 分。问题是,这一两个点里有多少是评测本身的抖动?
我把 SmolVLA 和 π0.5 在 LIBERO-Goal 和 LIBERO-Long 上反复跑,改的都是”理论上不该有影响”的东西:渲染器、MuJoCo 版本、数值精度、评测批大小、GPU 型号、策略的噪声种子。关键是每个 episode 在不同运行之间严格配对,初始状态、环境种子、策略噪声全对齐,同样的配置重跑能逐动作复现。
结论分两层。成功率均值确实很稳,四种实现改动最多只让均值移动 1.6 分,所有 95% 区间都在 ±5 以内。但单个 episode 一点都不稳:每种改动都会翻转 7% 到 14% 的 episode 结果,换个噪声种子翻转 22% 到 26%,在 LIBERO-Goal 上已经接近”每次独立重抽”的水平;六次运行里只有三分之二的 episode 结果始终一致。
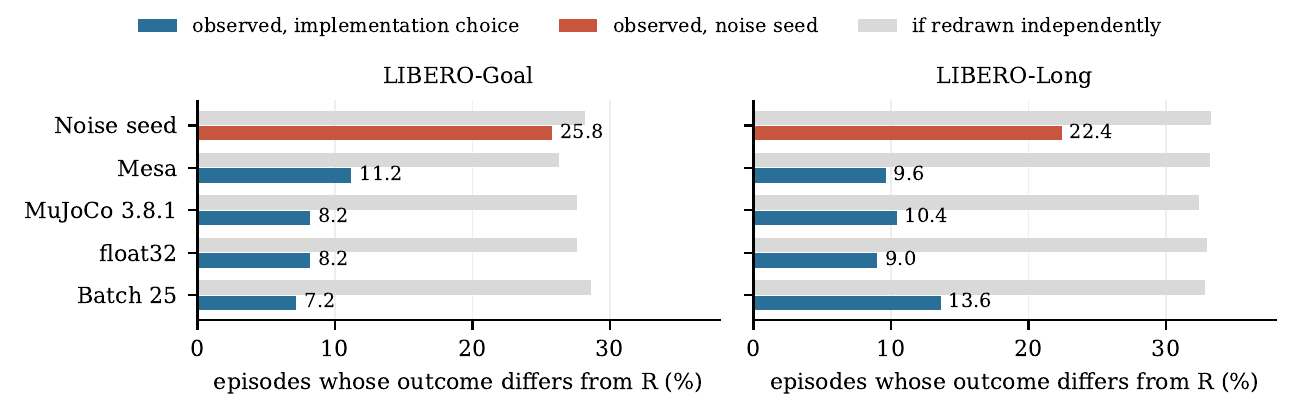
这引出论文里的一个小命题:配对比较的精度由翻转率决定,而不是均值差。翻转率越高,配对带来的精度红利就越少,换噪声种子在 LIBERO-Goal 上几乎把这份红利全吃掉了。顺手还发现一个坑:LIBERO 里有些 episode 的第一帧画面取决于环境的重置历史,所以评测批大小会悄悄改变初始画面。
实际意义是:比较两个策略的均值,LIBERO 够用;但如果要做逐 episode 的分析(比如”这个方法修好了哪些失败案例”),必须把整套实现钉死,否则你看到的很多”修复”只是噪声。
重新分析一篇 ACL Findings:能力还是协作过程
第三篇最特别,它不跑新实验,而是用预注册的方式重新分析别人公开的数据。Zhou 等人在 ACL 2026 Findings 上报告,LLM 智能体组成的群体存在一个”集体智能因子”,而且协作过程比成员模型的能力更重要。我原本的预设是,成员能力能解释掉大部分所谓的过程效应。
分析前我把停止规则写死了:如果在原论文回归用的那个子集上,过程和群体规模变量在成员能力之外还能多解释很大一块方差,就承认原论文对、结束项目。结果交叉验证的 ΔR² 是 0.357,停止规则触发了:在那个子集上,过程确实重要,原论文这一点站得住。
但事情没完。放到全部 108 个群体上,单靠成员平均能力和最强成员能力就能解释大部分方差(交叉验证 R² 0.864),不过这个数主要来自单一模型群体和混合群体之间的能力落差,只看混合群体时降到 0.363。另外还查出几处分析问题:原回归没说明就丢掉了 38 个全连接群体;图里所谓的”标准化系数”其实是把系数向量本身标准化了,而不是标准化预测变量,按标准做法算,平均能力和技能匹配度的效应相当;两个规模变量完全共线;单因子模型的 RMSEA 偏高却没报;所谓在新任务上的泛化其实是样本内评估。
这篇让我印象最深的是:预注册不是为了证明自己对。它逼着我在看到结果之前说清楚”什么结果算我错”,结果出来我错了一半,那就照实写。
三篇合起来,我会这样做评测
- 先估噪声,再看差距:dLLM 报 K,VLA 报翻转率和配对区间,任何小于噪声半宽的差距都不该写成结论。
- 能配对就配对:同一批输入、同一组随机数,配对比较的精度远高于两次独立运行。
- 把实现钉死:渲染、版本、精度、批大小、种子都写进报告,逐样本分析尤其需要。
- 预注册,并把失败写出来:三篇里有两篇的起点是失败的门槛检验,这些失败本身就是最有信息量的部分。
- 重新分析别人的数据很值得做:公开数据加上预先写死的分析计划,成本低,信息量很大。
三篇目前都在 TMLR 审稿中,arXiv 版本挂出后我会把链接补到这里,数据、代码和预注册协议都会随论文公开。如果你也在做模型评测,欢迎拿这份清单对照一下自己的实验,一个分数差先扣掉噪声,剩下的才是你真正的发现!