小鹏 VLA 2.0 站上牌桌,但离 FSD 还很远
我的立场比以前更明确了:VLA 不是纯概念了,但也远没到大家都已经做成的程度。
如果把标准放严一点,不看发布会里的架构图,也不看论文里的 benchmark,只看真实道路、真实用户、真实接管压力下能不能持续迭代,那我觉得现在能放在一个篮子里讨论的,主要就是两个样本:Tesla FSD 和小鹏 VLA 2.0。
但放在一个篮子里,不代表成熟度一样。FSD 更像已经跑过很多轮战争的系统,小鹏 VLA 2.0 更像刚把新一代武器推上前线。它很重要,也值得认真看,但离 FSD 的数据闭环、用户规模和长尾验证,还有很长一段路。
我看到小鹏 VLA 2.0 的时候,第一反应不是兴奋,而是有点恍惚。它让我想起以前在小鹏那段高压时间。外面看到的是 demo、发布会和几句口号,里面压着的是每一次接管、每一版策略、每一个体验问题背后的责任。
不是所有端到端都叫 VLA
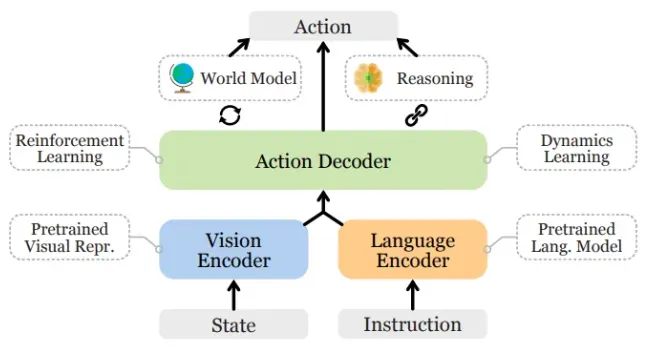
如果说具身智能领域,答案是有一些能玩的。比如 OpenVLA,7B 参数,主要面向机器人操作,输入图像和指令,输出机器人动作。它能跑,也有不少人基于它微调。
但如果问题限定在自动驾驶,我的答案会保守很多:没有一个我愿意称为开源稳定、可直接拿来跑车的模型。
现在最接近的应该是 NVIDIA Alpamayo。英伟达把它定位成面向自动驾驶的 open VLA family,包含模型、仿真和数据集,Alpamayo 1.5 也开放了 GitHub / Hugging Face 入口。这个很重要,说明自动驾驶 VLA 不再只是论文图。
但它仍然更像研究工具,不是量产方案。能在数据集和仿真里跑,不等于能在城市道路上替你兜底。自动驾驶最麻烦的地方从来不是 demo,而是出错之后谁负责,以及怎么证明它不会在极低概率场景里犯蠢。
真正能放进一个篮子的两个样本
我不太想用“同一张桌子”这种说法,听起来太像咨询报告。更朴素一点说,就是先放进一个篮子里看:谁真的在把感知、语言理解、驾驶动作、数据回灌和车端部署往一条链路里拧。
按这个标准,Tesla FSD 和小鹏 VLA 2.0 是现在最值得一起看的两个样本。FSD 的优势在于它已经被大量真实用户长期使用,哪怕它仍然明确要求驾驶员监督,但它承受过的真实道路压力、版本迭代压力和长尾压力,是大多数方案没有经历过的。
小鹏 VLA 2.0 的意义在另一边。按照小鹏自己的说法,它走的是 Vision-Implicit Token-Action 路径,想绕开传统 V-L-A 里先转成语言再生成动作的中间层。这个说法当然带着发布会包装,但方向上很清楚:国内厂商里确实有人不满足于继续堆模块,而是在尝试把视觉、驾驶知识和动作重新组织起来。
只是我不愿意把“小鹏已经发布 VLA 2.0”直接翻译成“小鹏已经追上 FSD”。这中间差的不是一个模型名字,而是几年的道路数据、用户里程、接管回灌、仿真体系和组织耐压能力。
VLA 当前最吃什么
先说一句不好听的:VLA 当前最依赖的不是模型结构,而是数据。
自动驾驶的 VLA 要学的不是图片里有什么,而是这个场景下一秒该不该动、该怎么动、为什么这么动。这需要大量真实驾驶数据、驾驶员接管数据、长尾危险场景、地图和交通规则,也需要闭环仿真把模型放回环境里反复折腾。
World model 能不能帮忙?能,但我不认为它能凭空变出驾驶能力。DriveVLA-W0 这类工作已经在尝试用 world model 预测未来图像,给 VLA 提供更密的训练信号。这个方向是对的,因为只用稀疏的方向盘、油门、轨迹点去监督一个大模型,太浪费模型容量。
但 world model 更像数据放大器,不是数据替代品。它可以生成未来、补充监督、做仿真压力测试,可是它自己也要从真实世界学。如果真实数据里没有足够多的中国式电瓶车、加塞、临停、施工围挡、奇怪标线,world model 也很难自己悟出来。
特斯拉这块最有意思。2025 年 FSD 在中国开始放出部分能力后,马斯克在 X 上说过,他们用了中国道路和标志的公开视频,在仿真里训练。这个说法挺关键,它说明 Tesla 确实在绕开中国训练数据不能出境这个问题。
但我没有看到可信公开信息能证明:FSD 是通过某个 world model 把北美能力完整迁移到中国。更合理的说法是,北美训练出来的底座能力可以迁移一部分,中国场景再靠公开视频、仿真和后续本地数据继续补。这里不是魔法迁移,还是数据、仿真、规则和工程优化的混合体。
差距主要不在 PPT 上
我现在对 VLA 的判断是:方向成立,量产困难,短期会被包装成各种端到端大模型卖给市场。
真正的差距不在 PPT 上。PPT 可以把感知、预测、规划、控制画成一条漂亮的箭头,但车开到路上以后,问题会变得很脏。它什么时候会错,错了以后能不能被发现,发现以后能不能稳定复现,复现以后下一版是不是真的修掉,这些才是工程真相。
闭环安全是第一关。开环 benchmark 再好看,也不能证明车在真实交通里不会越跑越偏。车是动态系统,模型一个小错会改变下一帧输入,错误会滚起来。
长尾数据是第二关。自动驾驶不是刷常规路况,真正要命的是小概率场景。突然横穿的人、逆行电动车、夜间施工、警察手势、临时交通管制,这些很难靠普通数据均匀覆盖。
实时性是第三关。VLA 要看图、读导航、理解规则、输出动作,还要给出可解释理由。车端芯片和控制频率不会因为模型很酷就迁就它,最后大概率还是要分层:大模型做意图和语义,小模型或传统控制做底层稳定。
验证是第四关。传统模块虽然笨,但边界相对清楚。VLA 的问题是能力很强,边界很糊。它能解释,不代表解释就是真的;它能规划,不代表每次规划都可控。
所以我不反对 VLA,相反我觉得它大概率会进入自动驾驶主链路。但它不会以一个大模型端到端接管车辆的浪漫方式落地。更现实的路径,是先进入数据挖掘、仿真生成、corner case 理解、驾驶策略候选生成,再慢慢往在线决策里渗透。
这也是小鹏 VLA 2.0 让我有复杂感受的地方。它确实站到了该站的位置上,可这条路最难的部分才刚开始。FSD 也不是神,但它已经在更大的真实压力里滚了很多轮。小鹏要追的不是一个发布会概念,而是那套把问题不断压回数据、仿真、训练、验证和量产版本里的机器。
如果你现在问我 VLA 能不能落地,我会说能。但不是宣传稿里那种落地。它落地的时候,应该会带着很多灰尘、返工、争吵和深夜版本。这个判断,可能比模型结构本身更接近我理解的自动驾驶。
参考
- NVIDIA Alpamayo 官方介绍
- NVIDIA Developer:Alpamayo for AV Development
- OpenVLA: An Open-Source Vision-Language-Action Model
- DriveVLA-W0: World Models Amplify Data Scaling Law in Autonomous Driving
- XPENG:VLA 2.0 发布与 Ultra 车型推送计划
- XPENG:VLA 2.0 全球路测与 2027 交付计划
- Tesla Full Self-Driving (Supervised) 官方说明
- CnEVPost:Tesla uses internet videos to train FSD for China
- TechCrunch:The China FSD workaround