从 Docker Compose 到 K8s:我的云服务器与 AI Agent 架构取舍
在公司做项目,耳边常年充斥着 K8s、K3s、Control Plane、Worker Node 这些词。听多了难免产生一种焦虑:好像生产环境不套一层 Kubernetes,服务就没法见人。
但看回我自己的一台腾讯云服务器,几个 Docker 容器用 Compose 串起来跑了一两年,博客顺畅,爬虫正常,挂载的小工具也稳得很。
我的结论很直接:单机服务继续用 Docker Compose 完全合理,业务没走到那一步,没必要为了概念去承受集群的运维复杂度。
Docker Compose 与 K8s 的真实边界
Docker Compose 是单机管理的利器:
腾讯云服务器├── Nginx (网关转发)├── Web / API (业务服务)├── PostgreSQL (主数据库)└── Redis (缓存与会话)容器崩了,守护进程负责拉起;发布新版本,拉新镜像重启即可。
它的局限很明确:管不住宿主机宕机。一旦云厂商底层硬件坏块、母机断电或宿主机升级重启,绑在这台机器上的所有策略都会一起失联。
K8s 管的则是由多台服务器拼起来的计算资源池。它不认具体的某台机器,只盯着声明的终态:比如“订单服务必须有 3 个副本在线”。某台机器失联,控制面自动在其他健康节点上把副本拉起来。
企业热衷 K8s,核心是为了解决团队分工和规模化交付:研发只需提交镜像和资源要求,平台统一调度、自动容灾、控制权限。
Server、Node、Pod 的工程实态
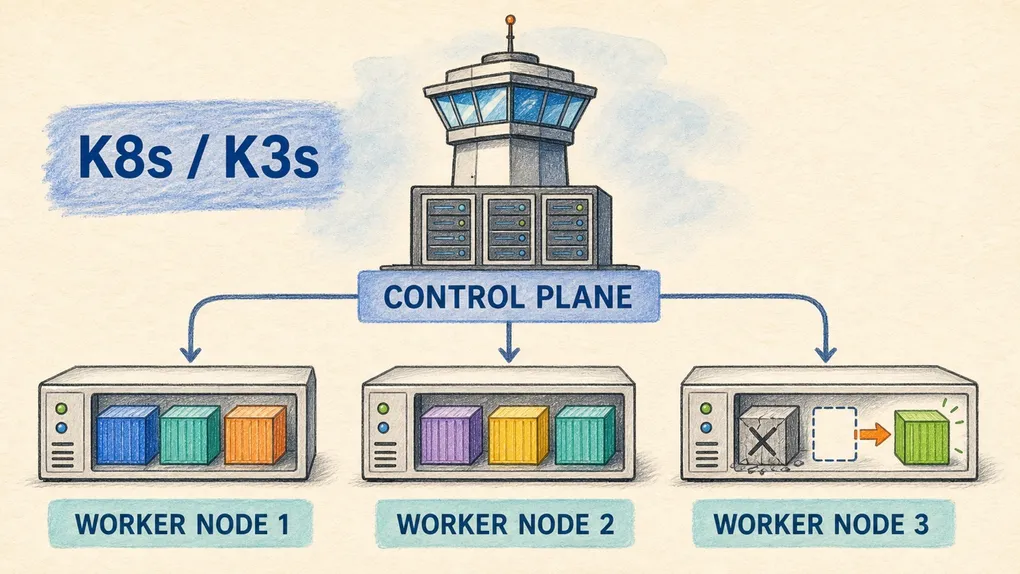
Kubernetes 的架构逻辑很直观:Control Plane(控制面)负责调度决策,Worker Node(工作节点)负责掏硬件干活。
Control Plane (Server) 调度、状态、集群管理 (API Server / Scheduler / etcd) │ ┌────────────┼────────────┐ │ │ │ Worker 1 Worker 2 Worker 3 业务容器 Pod 业务容器 Pod 业务容器 Pod- Server(控制面):集群的“调度塔台”。在标准 K8s 里由 API Server、Scheduler、Controller 和 etcd 组成;在轻量的 K3s 里打包为一个
k3s server进程。它不运行具体业务,只负责管理状态与分配任务。 - Node(节点):真正提供 CPU、内存和磁盘的服务器。节点上运行
kubelet与容器运行时(如 Containerd),接收 Server 的指令。 - Pod(豆荚):集群调度的最小原子单元。K8s 不直接调度裸容器,而是把容器装在 Pod 里。
在实际工程中,有三个常见的认知反差:
1. Pod 里的多容器:不是堆副本,而是 Sidecar 伴生
如果一个服务需要 3 个容器扛并发,应该起 3 个独立的 Pod 副本分散到不同节点。
同一个 Pod 里塞多个容器,通常属于 Sidecar(边车)模式。由于它们共享网络栈(localhost 和端口完全互通)与文件卷,适合做强绑定的辅助工作——比如主容器跑 Go 服务,边车容器在后台实时读本地日志推到 Elasticsearch,或者放一个 Envoy 代理拦截流量做鉴权。
2. Node 上的 Pod:必须混部才划算
很少有团队会让一台 Node 只跑同一种服务。 服务有各自的画像:有的吃 CPU(比如算力密集但内存只占 200M),有的吃内存(比如 Redis 缓存占 8G 但 CPU 基本闲置)。Scheduler 的默认策略是“拼积木”,将不同画像的 Pod 错峰塞在同一台 Node 上,把整机的物理算力榨干。只有核心中间件(如 Kafka 独占)或挂卡的机器,才会打上污点(Taints)做物理隔离。
3. Node 的分类与扩容触发点
集群规模扩大后,机器会打上标签按需调度:通用计算型、高内存型、GPU 算力型、带公网 IP 的 Ingress 网关节点,以及按需购买的低价竞价节点(Spot)。
真正需要新增 Node 的工程触发点只有两个:
- 物理资源彻底见顶:剩余碎片拼不出新 Pod 声明的配额(Request),Pod 开始报
Pending; - 多机容灾(高可用):即使单机配置高达 128 核 512G,也必须拆成至少 2~3 台 Node 打散副本,避免单点故障导致全业务瘫痪。
实战映射:AI Agent / RAG 系统的部署拓扑
以当下常见的 AI 知识库问答与 Agent 系统 为例,拆进 K8s 后的真实分工是清晰的三层解耦:
1. 三类 Node 的物理画像
- 编排 Node(通用 CPU 型):运行 LangChain / LangGraph 状态机编排引擎与 API 网关。它不吃 GPU,瓶颈在网络并发和等待大模型流式回传,最适合结合 HPA 随流量白天扩容、夜间缩容。
- 存储与检索 Node(高内存 + 高吞吐盘):运行向量数据库(Qdrant / Milvus)与关系库。HNSW 向量近邻搜索需要将索引全量常驻内存,并对切片原文进行高频 IOPS 读写,因此需要高内存机型并挂载云盘(PVC)。
- 轻量算力 Node(GPU 节点):大模型本体通常调用外部 API(DeepSeek / Claude 等),但本地向量化(Embedding)和语义重排(Reranker)模型更适合私有部署。本地调用延迟能压到 10~30ms,没有外网网络开销,也不产生额外的 token 账单。
2. 检索流水线:Embedding、倒排索引与 Reranker 的协作
知识库检索并非单纯的向量比对,生产环境普遍采用“初筛 + 精排”漏斗:
用户输入 Prompt │ ┌─────────────────────┴─────────────────────┐ │ │ 【向量通路: 语义相似】 【关键词通路: 字面精确】 │ │ Embedding 模型 (如 BGE-M3) 结巴分词 (Jieba) / 倒排索引 提问向量化 (Vector) 切词并匹配关键词段落 │ │ 向量近邻计算 (余弦相似度) BM25 词频计算打分 捞出语义相似切片 (西红柿 ≈ 番茄) 精确命中专有名词 (型号/工单号) │ │ └─────────────────────┬─────────────────────┘ ▼ 【混合检索合并: 粗选 Top-20 ~ 50】 │ ▼ 【Reranker 深度精排 (Cross-Encoder)】 成对输入: [提问 + 候选段落1] -> 0.94 分 成对输入: [提问 + 候选段落2] -> 0.12 分 ... (GPU Batching 并行打分,耗时仅 30~60ms) │ ▼ 【挑选最权威的 Top-3 ~ Top-5】 │ ▼ 注入 Prompt 送入大模型生成最终回答很多人的疑问是:对 50 篇候选文档逐一交叉打分,性能顶得住吗?
工程实测完全无感(约 30~80ms)。
首先,Reranker(如 bge-reranker-large、gte-multilingual-reranker)是基于 BERT 结构的双向交叉编码器(Cross-Encoder),参数量只有 35 亿,而且它不逐字生成文本,只输出一个相关性浮点数;
其次,工程上不是写循环单次调用,而是把 50 对文本打包为一个 Batch 一次性灌进 GPU 矩阵计算。相比大模型思考吐字动辄 23 秒的耗时,这几十毫秒的开销微乎其微,却能大幅减少无用上下文与大模型幻觉。
什么时候真的该换?
K3s 把标准 Kubernetes 裁剪合并进单个二进制包,内存占用压缩到了几百兆,对于边缘节点、本地测试机和轻量私有集群是极好的方案。
但我决定留在 Docker Compose 还是切到 K8s/K3s,考量的标准始终只有一个:单台机器宕机带来的停机损失,是否已经超过了维护一套分布式集群的心智与成本。
如果答案是肯定的,那么我需要至少 3 台服务器、跨机容灾、外部负载均衡以及持久化存储卷; 如果是个人工具、独立博客或小型轻载服务,一台配置适中的云服务器,配上干净的 Docker Compose、规范的日志转储和异地冷备,往往能活得更稳、更轻松。
让业务复杂度来倒逼架构演进,永远好过被技术名词推着走。